文章 · GEO
开发者API和手机AI给出不同回答,GEO客户该验收哪个
服务报告显示某个模型提到了公司,打开手机里的AI却看不到同样答案,这不一定是谁操作错了。开发者接口和面向用户的应用可能不是同一条服务链。对GEO采购者来说,关键不是争论哪个答案更“真”,而是合同想改善哪个入口,以及现有证据是否真的来自那个入口。先把观察对象说准确,后面的百分比才有意义。
同一家提供商,不等于相同的回答环境
开发者API通常让软件按选定模型和参数发请求;消费端应用还可能包含自己的搜索、问题改写、产品路由和会话状态。不能仅凭名称相似就推断它们完全一致,也不能拿普通聊天接口的答案证明联网消费端找到了官网。
检验时至少记录模型或产品名、入口、是否联网、语言、时间、是否新会话。某项设置看不到,就写未知,不替平台猜测。软件里勾选“联网”也只是请求使用搜索,应进一步看该次响应是否有可核对的搜索或来源信息。
根据客户目标决定主验收入口
如果客户最关心手机里的采购建议,消费端观察就应是单独的验收部分。API适合按固定流程重复记录,但在没有证明一致性前,它只能提供接口样本。二者可以互相帮助诊断,不能合并成一个“全网推荐率”。
| 客户真正关心的问题 | 主要观察 | 不能替代它的材料 |
|---|---|---|
| 手机AI会不会把公司列为候选 | 指定消费端的新会话记录 | 同厂商API一次提名 |
| 官网资料是否被联网调用 | 带来源证据的实际回答 | 纯聊天模型的记忆答案 |
| 不同时间是否有变化 | 同入口同题组重复观察 | 只选最好的一张截图 |
| 会不会带来咨询 | 可识别访问和合格线索 | 模型自己说愿意推荐 |
一轮对照应该怎样记录
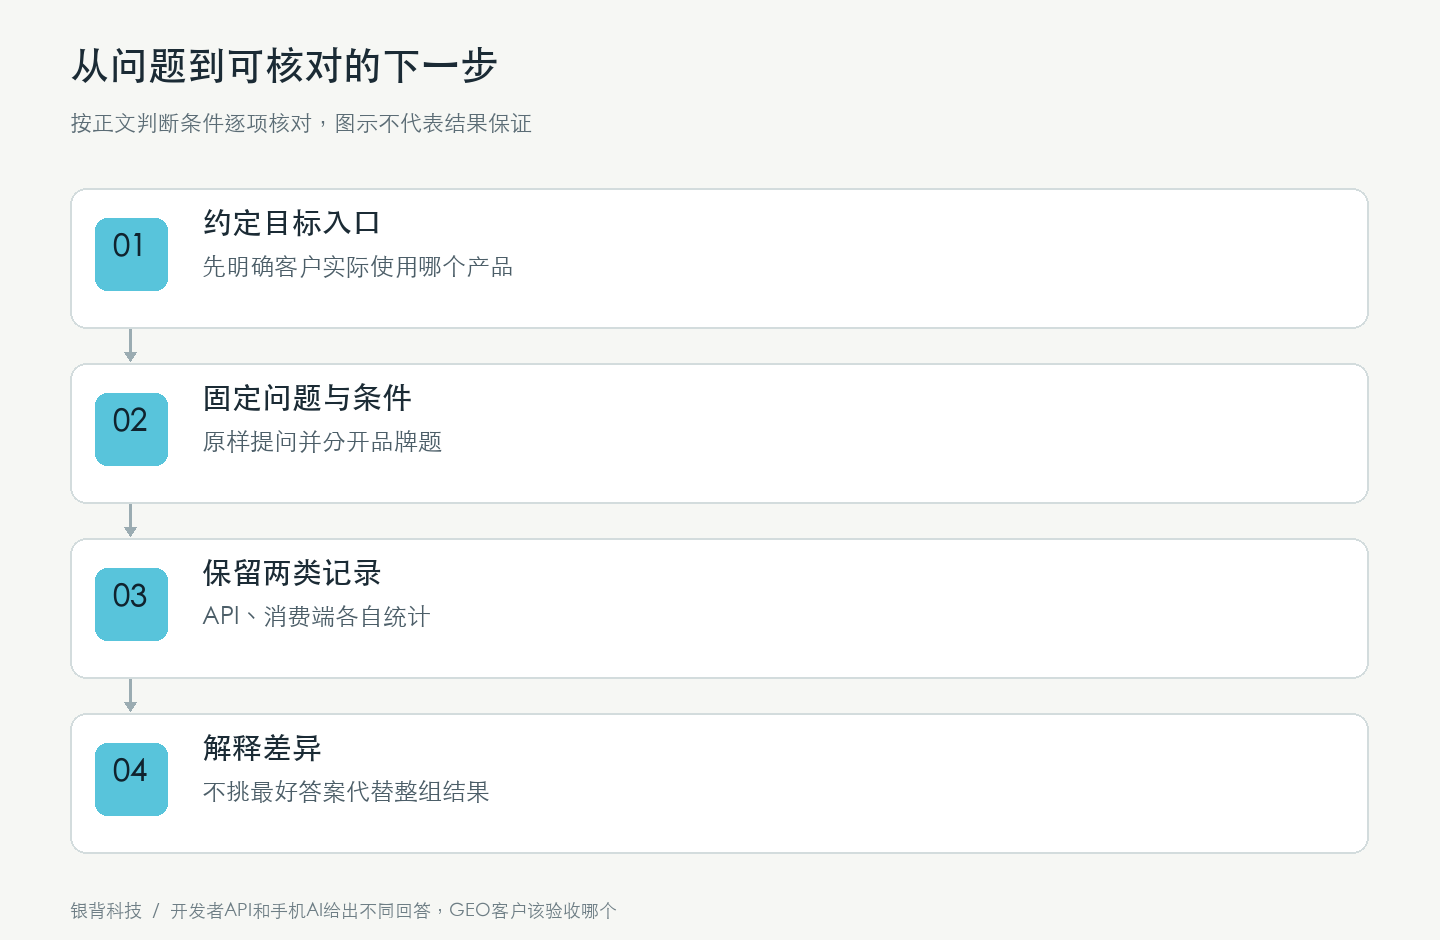
下面是一组对照测试示例:选择六道问题,其中四道不含品牌的采购需求题,两道品牌事实核实题。在两个指定入口中,以新会话分别提问,保存完整回答与来源。下一窗口沿用同样问题,不把一次没有结果的问题偷偷换掉。
| 记录字段 | 填写要求 |
|---|---|
| 原问题与类型 | 原样保存;品牌与非品牌分组 |
| 实际入口 | 具体App/网页或API,不只写供应商品牌 |
| 搜索与会话 | 开关、实际来源、新会话及可见个性化状态 |
| 结论证据 | 实体是否准确、推荐片段、有效引用 |
| 失败与费用 | 超时/拒答/未搜索单列;API费用另记 |
遇到不一致,先定位差异而非挑选答案
API知道公司但消费端没找到,可能是检索路径不同,也可能只是当次回答波动。先比较两者是否实际联网、是否引用同一来源、是否误认同名公司。只有看到来源与条件,才能形成进一步假设;没有证据就不要断言某平台故意忽略品牌。
如果消费端被连续追问后才推荐,公司名又被写进提示词,应把它标为引导后的回答。这个记录可用于诊断事实,但不能计入非品牌问题中的自然候选率。测试人员自己的登录历史也可能影响观察,报告应尽量说明条件和无法控制的部分。
还可以给报告增加一列“这个记录不能说明什么”。例如,一条API回答能证明该次接口返回了某段文字,不能证明手机App所有用户都会看到它;一次消费端截图能证明当时的可见回答,不能证明整个平台的平均表现;一次来源链接能证明展示了该网址,不能自动证明答案中的每个断言都正确。这一列不降低报告价值,反而帮助采购方避免把局部成功误当成覆盖全部渠道的长期效果。
验收报告应该允许不同结论并存
合格报告可以写“接口样本中出现正确候选,消费端抽检尚未观察到”,也可以写“消费端出现引用,但没有访问来源可验证”。这类表达比把所有结果合成一条上涨曲线更有价值。样本少或失败多时,先报告不确定性,不承诺代表整个平台。
Bing官方AI Performance说明也限定其支持的AI体验和数据含义。企业应采用同样的范围意识:哪个渠道采到了什么,就说明什么。工具的任务是让证据更清楚,而不是替未知渠道补一个看起来完整的成功率。
参考资料
你的下一步
如果现有报告与手机里的回答对不上,可以先把入口、问题和原回答放到同一张表里,再决定需要补哪一种观察。